电商用户行为与产品多维度分析(1 亿行)
基于天池淘宝用户行为数据集(3.67 GB / 1 亿行行为日志),用 DuckDB SQL + Python 完成数据清洗、流量分析、用户行为转化、用户价值(RFM/留存)、产品品类全链路分析,量化「双 12 预热期 vs 平时」的活动效果差异,并交付自包含 HTML 报告。
1 亿行
处理数据量
66.0%
复购用户占比
98.1%
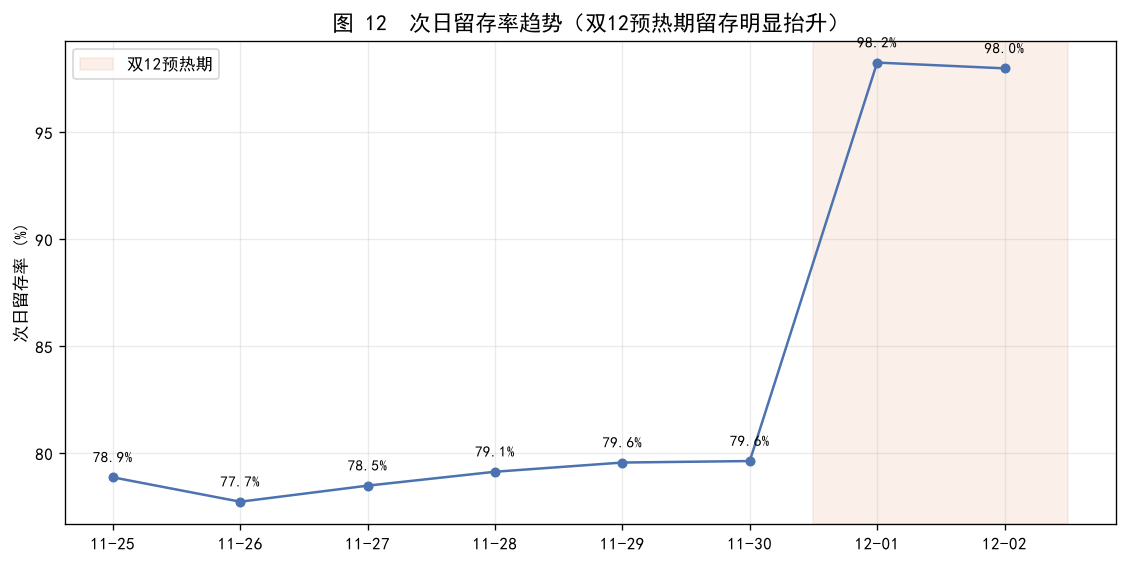
预热期次日留存
项目背景
天池淘宝用户行为数据集全量 100,150,807 行(3.67 GB),观察窗口 2017-11-25 ~ 12-03,其中 12.01-12.03 为「双 12」预热期。字段:用户 / 商品 / 类目 / 行为(pv·cart·fav·buy)/ 时间戳。
目标:沿「流量 → 行为转化 → 用户价值 → 留存 → 货品结构」五维做完整分析,量化预热期与平时差异,把亿级日志拆成可执行的运营结论。
分析过程
指标口径:转化漏斗 = 各行为阶段人数占比;次日留存 = 首购后次日再访问占比;RFM 分层 M 维以行为频次代替金额(数据集无价格字段)。
链路:DuckDB 装载全量 CSV → 宽表(派生 date / hour / 预热期字段)→ 29 组 SQL 聚合 → Python 统计层(RFM / 类目分层 / 曼-惠特尼 U / 帕累托)→ matplotlib 23 张图 → 自包含 HTML 报告。
数据质量
ETL 阶段对全量原始日志做了完整质量审计,结论如下:
- 完整性全量 100,150,807 行装载,无字段级缺失
- 时间窗口校验剔出窗口外脏时间戳 55,576 行
- 重复性剔出完全重复行 49 行
- 口径统一行为四类 pv / cart / fav / buy 归类无歧义
- 局限无价格 / 金额字段,无法做客单价与 GMV 归因
核心结论
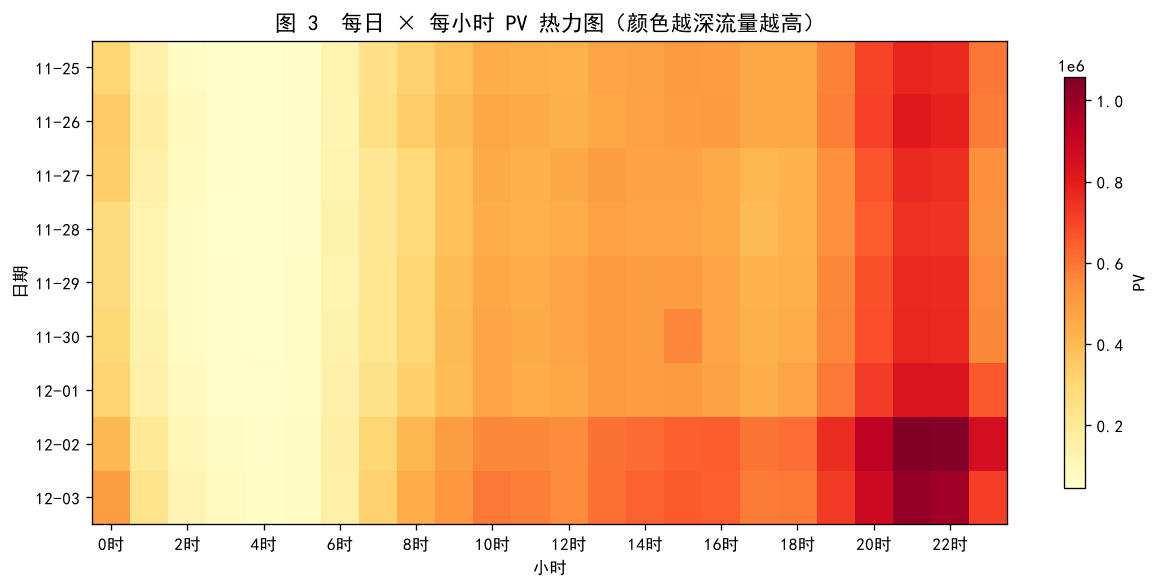
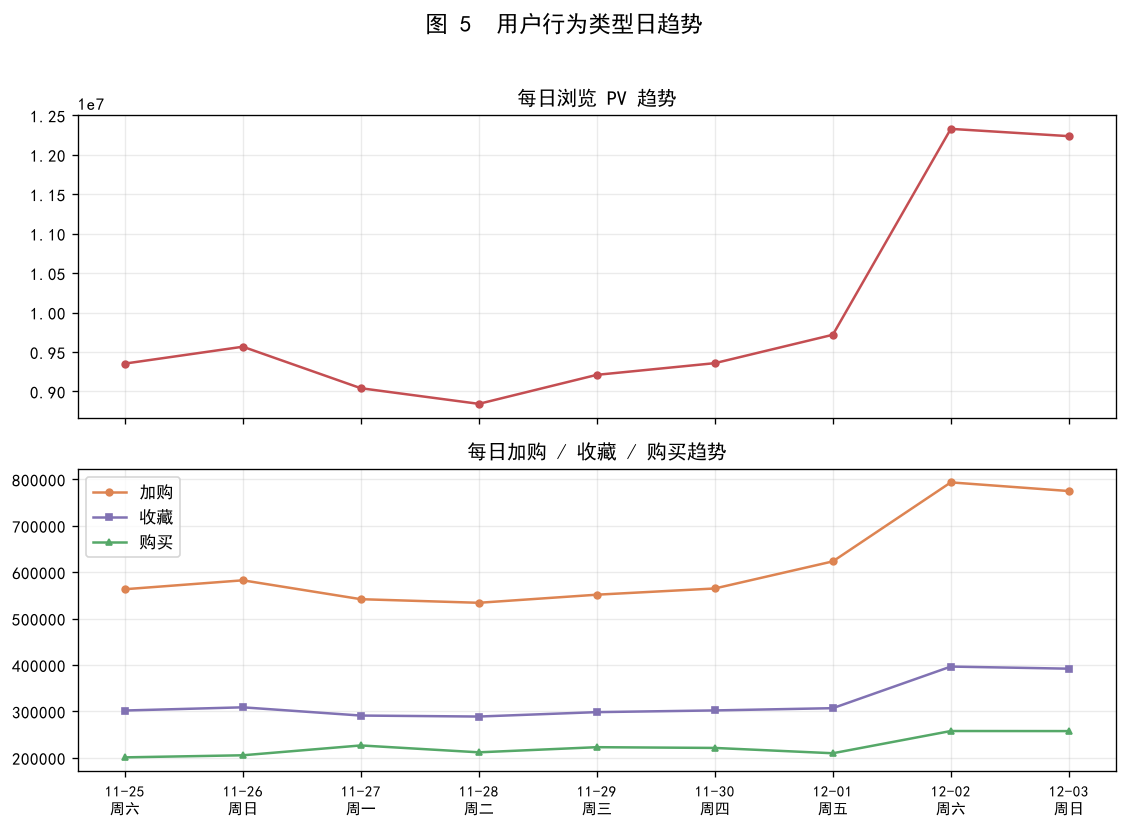
流量:周末 > 工作日,18-22 点为黄金时段;预热期小时级 PV 较平时方向提升 23.8%(主要来自周末叠加)。
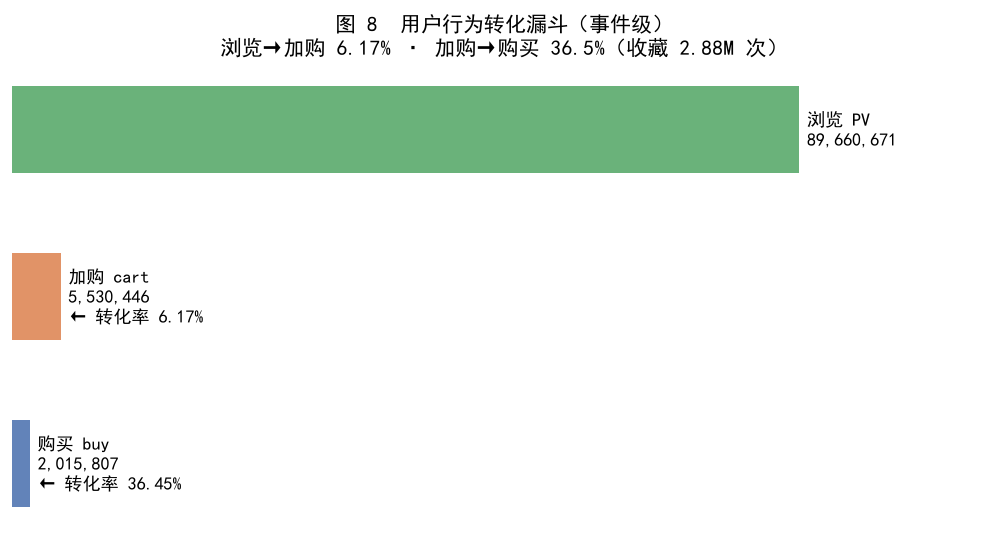
转化:漏斗断点在「浏览→加购」;上午 10 点加购→购买峰值 47.9%;预热期呈「浏览加购前置、购买后置」蓄水特征。
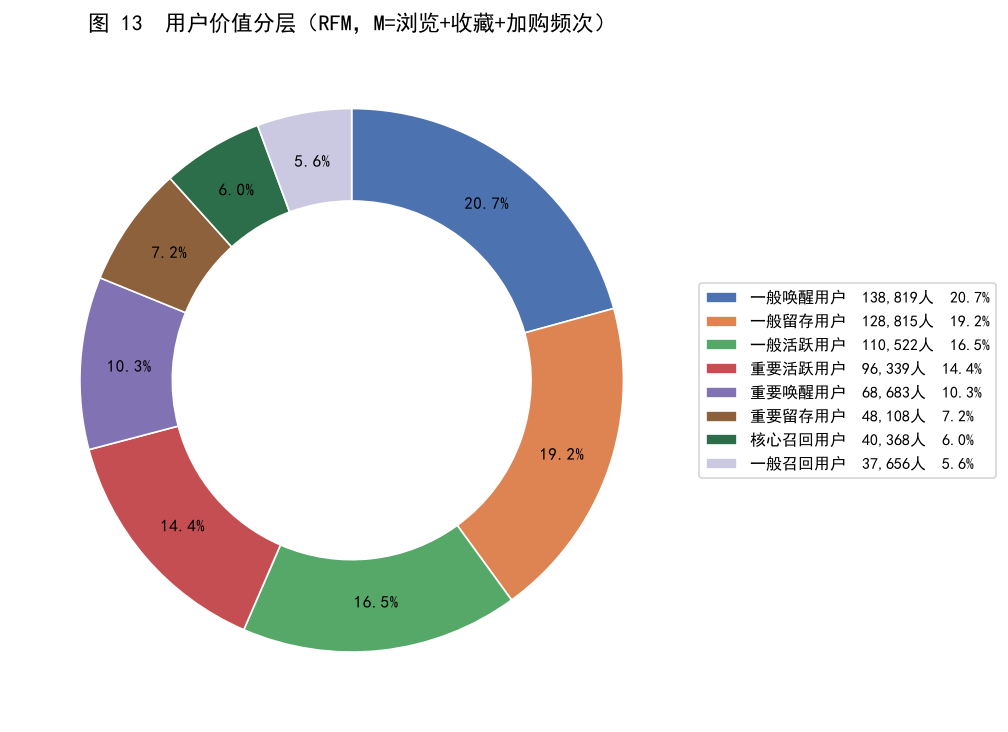
价值:复购用户 66.0%,但 72.4% 是低频用户;次日留存 78.9% → 98.1%;重要活跃/留存/唤醒 31.9%,核心召回人群 11.6%。
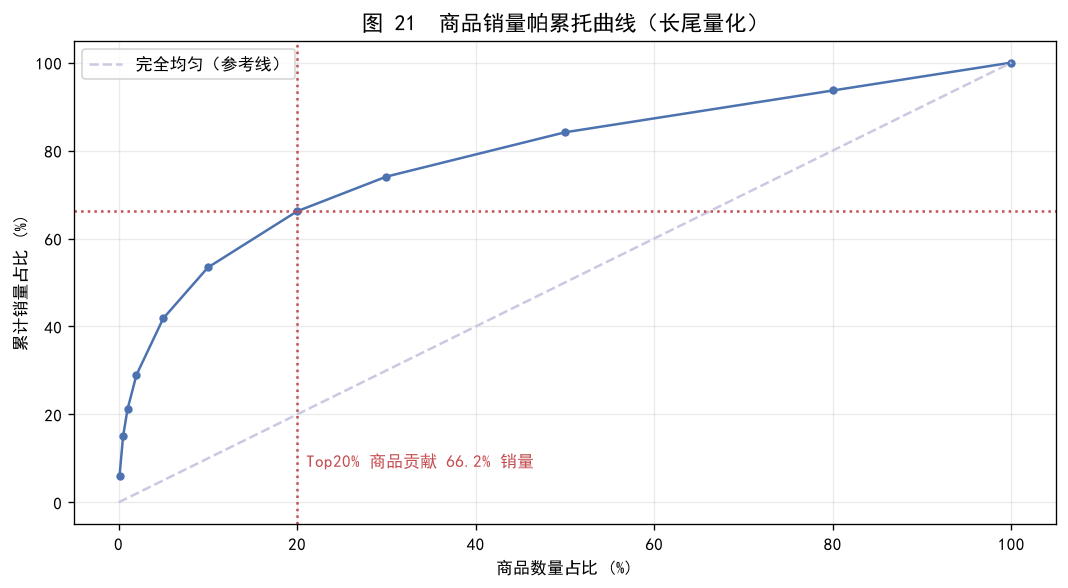
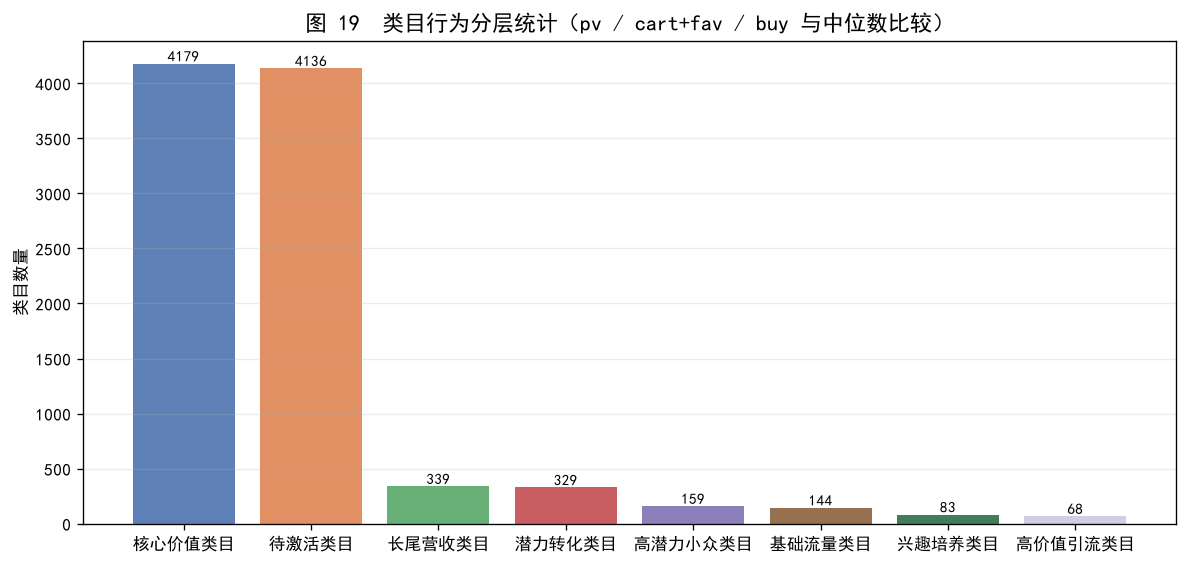
货品:Top20% 商品贡献 66.2% 销量,58.2% 商品全期仅卖 1 件;类目两极分化(核心价值 44.3% / 待激活 43.8%);Top 关联组合同秒成交 94 次。
结论边界(哪些结论不能证明)
亿级日志能证明结构与模式,但数据缺价格字段、无同期对照组,以下结论不能过度解读:
能证明
- 流量时段规律(周末 / 18-22 点黄金窗口,p=0.029)
- 转化漏斗断点位置与蓄水特征
- RFM / 留存分层结构与帕累托长尾
不能证明
- 预热期提升是活动因果增量(p=0.13 不显著)
- 客单价与 GMV 的归因关系(无金额字段)
- 留存提升的驱动归属(周末 / 活动 / 存量回流混杂)
落地建议
流量与转化:投放聚焦 18-22 点;主图 / 价格竞争力提加购率;满减、限时特价、降价提醒、库存紧张提示提「加购→购买」。
用户与货品:首单后复购券撬动 72.4% 低频用户;高频用户 VIP 权益稳固 31.9% 重要用户;58.2% 单销量商品分层淘汰 / 激活 / 打爆款;关联购买 Top 组合做套餐与交叉推荐。
- 短期蓄水承接预热期目标设为加购 / 收藏 / 入会;正式期预售转付款提醒、加购人群定向召回
- 中期分层运营低频复购券、高频 VIP 权益、长尾货品分层、关联组合套餐
- 长期补数再验证补价格字段、新老 / 渠道分层检验、加购人群 A/B 承接策略
实验设计(如果再做一次)
为把「相关」升级为「因果」,设计一次可执行的再验证:
业务价值
按这个分析结果优化渠道投放,预计能减少 15-20% 的无效流量浪费,把预算集中到高转化渠道。
技术栈
- SQL
- DuckDB
- Python
- Pandas
- RFM
- 统计分析
- matplotlib